Détection des tours de parole
La détection de tour de parole indique à votre application, pendant une session de transcription en temps réel, quand l'utilisateur commence à parler et quand il a terminé. Utilisez-la chaque fois que votre application agit à la fin de ce que dit quelqu'un : un agent vocal qui répond, une commande vocale ou un sous-titrage en direct qui ferme sa ligne.
Pour comprendre pourquoi la fin d'un tour est difficile à détecter, et comment choisir entre répondre plus tôt et couper la parole aux utilisateurs, consultez Tours de parole et prise de tour.
Activer la détection des tours de parole
Pour activer la détection de tour, ajoutez un objet turn_detection au message session.update qui configure votre session en temps réel. Un objet vide applique les valeurs par défaut :
{
  "type": "session.update",
  "session": {
    "audio_format": { "encoding": "pcm_s16le", "sample_rate": 24000 },
    "turn_detection": {}
  }
}Envoyez-le avant le premier fragment audio : une fois l'audio démarré, la session rejette toute modification de ses paramètres avec l'erreur Session fields cannot be changed after audio has started.
La détection de tour fonctionne uniquement dans les sessions en temps réel, et pas en combinaison avec la diarisation :
- Une requête de transcription de fichier avec
turn_detectionrenvoie une erreur 400 :turn_detection is only supported on the realtime transcription endpoint. - Une session en temps réel qui définit à la fois
turn_detectionetdiarizereçoit l'erreurDiarization is not compatible with turn detection.Pour étiqueter les locuteurs, consultez Identifier les locuteurs.
L'exemple suivant envoie un fichier WAV en streaming à son propre rythme et affiche chaque événement de tour avec sa position dans l'audio, puis la transcription complète.
Le SDK Agents vocaux envoie turn_detection via la configuration stt. Pour les sessions WebSocket brutes, envoyez session.update avec websockets en Python et ws en TypeScript.
import asyncio
import base64
import json
import os
import wave

import websockets

MODEL = "voxtral-mini-transcribe-realtime-3"
URL = f"wss://api.mistral.ai/v1/audio/transcriptions/realtime?model={MODEL}"
HEADERS = {"Authorization": f"Bearer {os.environ['MISTRAL_API_KEY']}"}
AUDIO_FILE = "customer_call.wav"  # 16-bit mono PCM WAV

async def send_audio(ws, path):
    with wave.open(path, "rb") as wav:
        while chunk := wav.readframes(wav.getframerate() // 10):
            await ws.send(json.dumps({"type": "input_audio.append", "audio": base64.b64encode(chunk).decode()}))
    await ws.send(json.dumps({"type": "input_audio.end"}))

async def main():
    with wave.open(AUDIO_FILE, "rb") as wav:
        sample_rate = wav.getframerate()

    async with websockets.connect(URL, additional_headers=HEADERS) as ws:
        await ws.recv()  # session.created
        await ws.send(json.dumps({
            "type": "session.update",
            "session": {
                "audio_format": {"encoding": "pcm_s16le", "sample_rate": sample_rate},
                "turn_detection": {},
            },
        }))
        sender = asyncio.create_task(send_audio(ws, AUDIO_FILE))

        async for message in ws:
            event = json.loads(message)
            if event["type"] == "session.updated":
                print("turn_detection:", event["session"]["turn_detection"])
            elif event["type"].startswith("turn."):
                print(f"{event['time_s']:6.2f}s  {event['type']}  {event.get('end_reason', '')}")
            elif event["type"] == "transcription.done":
                print("text:", event["text"])
                break
            elif event["type"] == "error":
                print("error:", event["error"]["message"])
                break
        sender.cancel()

asyncio.run(main())La sortie ressemble à ceci :
turn_detection: {'start_threshold': 0.5, 'eager_end_threshold': 0.5, 'end_threshold': 0.33, 'min_silence_ms': 500, 'end_timeout_ms': 3000}
  0.00s  turn.start
  1.36s  turn.eager_end
  1.44s  turn.resume
  2.56s  turn.eager_end
  2.64s  turn.resume
...
 34.56s  turn.eager_end
 35.12s  turn.end  threshold
text: Thanks for calling Northwind Support. This is Daniel. How can I help you today? [...]Dans cette sortie :
session.updatedreprend les valeurs appliquées par la session. Avec un objetturn_detectionvide, ce sont les valeurs par défaut.- Chaque pause entre les phrases produit un
turn.eager_end, suivi d'unturn.resumequand le locuteur continue. - Le tour ne se termine par un
turn.endque lorsque le locuteur s'est arrêté. Son champend_reasonindique ce qui l'a terminé.
Fonctionnement de la fin de tour de parole
Pendant la transcription, le modèle évalue de 0 à 1 la probabilité que l’utilisateur se trouve dans un segment de parole sémantiquement actif. Le serveur compare ce score à vos seuils et fait passer la session entre trois états. Chaque passage envoie un événement de tour.
Chaque flèche représente un événement, avec la condition qui l'envoie.
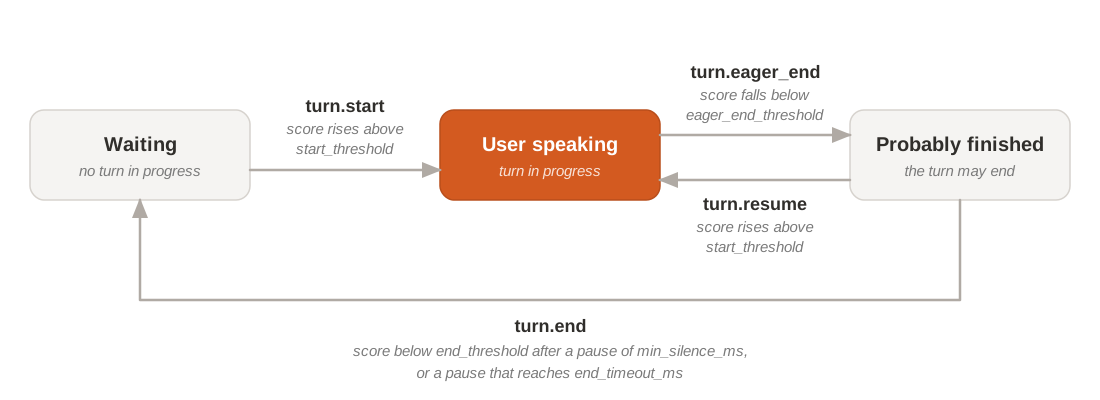
Le même ordre s'applique dans toutes les sessions :
- Un tour commence toujours par un
turn.start. - Un
turn.resumeannule la fin anticipée qui le précède, et le tour continue. - Après un
turn.end, leturn.startsuivant ouvre un nouveau tour.
Le silence minimal et le délai de fin bornent la décision dans le temps. Le tour ne peut pas se terminer tant que la pause n'a pas atteint min_silence_ms, même quand le modèle est confiant. Une fois que la pause atteint end_timeout_ms, le tour se termine même si le modèle n’est pas confiant, avec end_reason défini sur timeout.
Événements et synchronisation du texte
Les événements de tour arrivent dans le même flux que les événements de transcription. Chacun porte time_s, la position dans l'audio en secondes depuis le début du flux, et non l'heure de votre horloge.
| Événement | Champs | Envoyé quand | Votre application peut |
|---|---|---|---|
turn.start | time_s | L'utilisateur commence à parler | Marquer le début du tour, par exemple pour indiquer que l'utilisateur est en train de parler. |
turn.eager_end | time_s | L'utilisateur a probablement terminé | Commencer un travail que vous pourrez abandonner, comme préparer une réponse. |
turn.resume | time_s | L'utilisateur continue après une fin anticipée | Abandonner le travail commencé à la fin anticipée. |
turn.end | time_s, end_reason | Le tour est terminé | Agir sur le tour : répondre, exécuter la commande ou fermer la ligne de sous-titre. |
end_reason vaut threshold quand c'est le score qui a mis fin au tour, ou timeout quand c'est le délai de fin.
Attendez turn.end avant toute action irréversible, comme envoyer un message ou appeler un outil qui modifie des données. Les fins anticipées sont fréquentes : la plupart des pauses entre les phrases en envoient une.
Les derniers mots arrivent après l'événement de tour
La transcription est en retard sur les événements de tour. Quand turn.end survient, le texte des derniers mots du tour peut encore être en route : il arrive dans les événements transcription.text.delta suivants.
Les événements de texte ne comportent pas de champ de temps ; vous ne pouvez donc pas les associer à un tour par horodatage. Pour construire le texte complet d'un tour :
- Continuez d'ajouter les deltas de texte au tour en cours après
turn.end. - Finalisez le texte du tour une fois le délai de streaming écoulé après l'événement, ou à l'arrivée du
turn.startsuivant. - Agissez sur le texte complet, par exemple en l'envoyant au modèle qui rédige la réponse.
Lors d'un turn.eager_end, le texte reçu jusqu'ici suffit pour commencer à préparer une réponse. Si vous l'envoyez à turn.end, vérifiez que les mots arrivés entre-temps ne changent pas la demande.
Pour le délai de streaming et son effet sur la précision, consultez Transcription en temps réel et Latence.
Ajuster les seuils
Cinq paramètres de turn_detection contrôlent le moment où les tours commencent et se terminent. Ne définissez que ceux que vous voulez modifier : les autres conservent leurs valeurs par défaut.
Partez de l'une des configurations courantes, puis modifiez un seul paramètre à la fois et testez avec des enregistrements de vos utilisateurs réels.
| Paramètre | Valeur par défaut | Ce qu'il fait | À modifier quand |
|---|---|---|---|
start_threshold | 0.5 | Seuil à partir duquel on considère que l'utilisateur a commencé ou repris la parole. | Augmentez-le si les tours de parole démarrent trop facilement, par exemple à cause du bruit de fond. |
eager_end_threshold | 0.5 | Seuil à partir duquel on considère que l'utilisateur a peut-être fini de parler, ce qui déclenche une fin anticipée. | Diminuez-le si les fins anticipées se déclenchent trop souvent. |
end_threshold | 0.33 | Seuil à partir duquel on considère que l'utilisateur a fini de parler, ce qui met fin au tour de parole. | Diminuez-le pour couper moins souvent la parole aux utilisateurs. La réponse arrive alors plus tard. |
min_silence_ms | 500 | Pause minimale avant que le tour de parole puisse se terminer. | Augmentez-le pour éviter que les tours de parole ne se terminent trop tôt. La réponse arrive alors plus tard. |
end_timeout_ms | 3000 | Pause maximale au bout de laquelle le tour de parole se termine dans tous les cas. | Diminuez-le pour limiter plus strictement l'attente maximale. |
Les seuils doivent conserver leur ordre : start_threshold doit être au moins égal à eager_end_threshold, lui-même supérieur à end_threshold, et end_timeout_ms doit être au moins égal à min_silence_ms. Sinon, la session renvoie une erreur.
Configurations courantes
Deux jeux de valeurs couvrent la plupart des applications. Choisissez le plus proche, puis ajustez les paramètres individuels à partir de là.
| Configuration | start_threshold | eager_end_threshold | end_threshold | min_silence_ms | end_timeout_ms | Meilleur cas |
|---|---|---|---|---|---|---|
| Par défaut | 0.5 | 0.5 | 0.33 | 500 | 3000 | Un bon point de départ pour la plupart des conversations. Vous obtenez ces valeurs avec un objet turn_detection vide. |
| Agressive | 0.5 | 0.4 | 0.33 | 300 | 2500 | La vitesse compte avant tout, comme dans les échanges rapides : le tour se termine plus vite après l'arrêt de l'utilisateur, au prix de coupures de parole plus fréquentes. |
Aucun champ ne permet de sélectionner une configuration par son nom : envoyez ses valeurs dans turn_detection. Par exemple, la configuration Agressive :
{
  "type": "session.update",
  "session": {
    "audio_format": { "encoding": "pcm_s16le", "sample_rate": 24000 },
    "turn_detection": {
      "start_threshold": 0.5,
      "eager_end_threshold": 0.4,
      "end_threshold": 0.33,
      "min_silence_ms": 300,
      "end_timeout_ms": 2500
    }
  }
}