Mission : un agent et ses agents de développement construisent jq à partir de son manuel, avec une évaluation sur les tests de jq
Certains travaux prennent des heures : porter une bibliothèque dans un autre langage, construire un analyseur à partir de sa grammaire. Un
agent peut les réaliser par jalons, à condition que du code, et non l'agent, évalue chacun d'eux. Ici, un
agent de planification construit jq 1.6 en Python, dans le package jqpy/, à partir du seul
manuel de jq. Dès le deuxième jalon, il confie des fonctionnalités à des sous-agents de développement qui s'exécutent en parallèle dans sa
sandbox. Après chaque jalon, un hook exécute la suite de tests de jq sur l'implémentation, soit 307 cas conservés hors
de l'espace de travail des agents, et place le score sur la première ligne de la réponse du planificateur. Un juge lit cette réponse
et décide si un jalon supplémentaire en vaut la peine. Une ligne que vous saisissez oriente le jalon en cours.
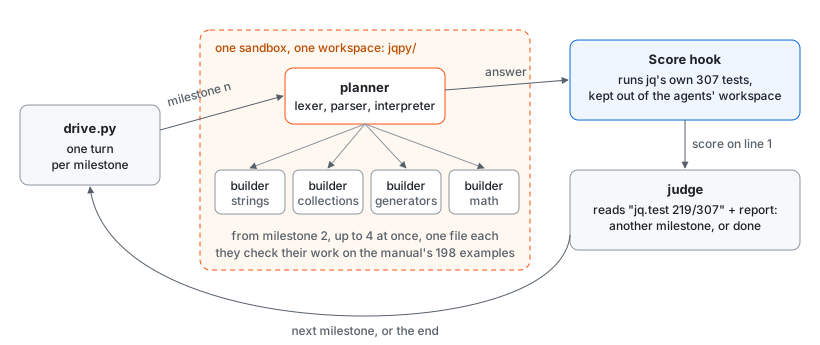
Lisez le schéma de gauche à droite : chaque jalon correspond à un tour du planificateur, évalué avant que le juge ne le voie.
Lors de notre exécution, deux jalons ont pris 26 minutes et consommé 6,9 millions de tokens. L'implémentation a réussi 129, puis 219 des 307 tests de jq.
Fonctionnalités illustrées : des sous-agents dans la
sandbox du planificateur, un skill chargé depuis un répertoire,
un hook post_agent_turn qui exécute
une commande dans la sandbox et remplace la réponse,
des tours avec des clés d'idempotence et
un délai d'expiration, des événements en temps réel,
des instructions en cours d'exécution, un juge avec
une sortie structurée, et
agents serve, où la mission
continue après l'arrêt de son pilote.
Exécution : depuis le dossier de l'exemple, avec Docker en cours d'exécution et MISTRAL_API_KEY définie :
uv run python drive.py jq-1 2
Le planificateur et ses agents de développement
Le planificateur gère le cœur du système : l'analyseur lexical, l'analyseur syntaxique et l'interpréteur. Chaque agent de développement gère un fichier
sous jqpy/builtins/, que le planificateur lui attribue au démarrage. Ainsi, deux agents de développement ne modifient jamais le
même fichier. Tous chargent le skill jq-manual : le manuel de jq 1.6, ses 198 exemples sous forme de dev_tests.py,
et ces règles d'organisation des fichiers.
agent = agents.Agent(
    model="mistral-large-4",
    name="jq-mission",
    instructions=PLANNER,
    environment=(
        agents.MistralSandbox(default_exec_timeout_seconds=300)  # dev_tests.py takes minutes; the default is 30 s
        if os.environ.get("MISSION_SANDBOX") == "mistral"  # served, an agent with subagents needs it
        else agents.LocalDockerSandbox()
    ),
    skills=[agents.LocalSkillBundle.from_directory(HERE / "skills" / "jq-manual")],
    subagents=[
        agents.Subagent(
            name="builder",
            description="Implements one jq feature in the one jqpy file you name, from the manual sections you give.",
            instructions=BUILDER,
            hooks=[Tokens()],  # no Score: the score is the planner's, once its builders are done
            builtins=agents.Builtins(subagents=False),
        )
    ],
    subagent_policy=agents.SubagentPolicy(concurrent_child_turn_limit=4),
    hooks=[Score(), Tokens()],
)Les agents de développement s'exécutent dans la sandbox du planificateur et écrivent dans le même espace de travail. Quatre au maximum s'exécutent
simultanément, et Builtins(subagents=False) empêche un agent de développement de lancer ses propres agents de développement. Le
hook Tokens additionne les tokens des appels au modèle du planificateur et des agents de développement.
Sur votre machine, l'implémentation s'exécute dans une sandbox Docker.
Avec MISSION_SANDBOX=mistral, elle s'exécute dans une
MistralSandbox, qui nécessite le rôle d'espace de travail cloud_user,
affiché sous le nom Mistral Cloud User dans la console d'administration.
Un score calculé par le code, pas par le modèle
Les agents vérifient leur travail sur les exemples du manuel. Le score qui compte provient
d'une autre source : la suite de tests de jq 1.6, held_out/jq.test, qui reste dans le dossier de l'exemple. Après
chaque tour du planificateur, le hook Score la copie avec score.py dans la sandbox, hors de
l'espace de travail, lance l'évaluation et place la ligne du score avant le rapport du planificateur :
class Score(agents.Hook):
    """After each planner turn, run jq's held-out tests on the build and put the score first in the answer."""

    async def post_agent_turn(self, ctx, answer):
        score = await ctx.sandbox.write_file("score.py", SCORE)
        tests = await ctx.sandbox.write_file("jq.test", HELD_OUT)
        run = await ctx.sandbox.execute(f"python3 {score} {tests}", timeout_seconds=300)
        lines = run.stdout.strip().splitlines()
        line = lines[-1] if run.exit_code == 0 and lines else f"score failed: {run.stderr[-300:]}"
        return agents.hook.PostAgentTurnHookAccept(
            acceptance=agents.hook.ReplaceAssistantContent(
                content=[agents.TextContentBlock(text=f"{line}\n\n{answer.text}")]
            )
)score.py lit les tests, puis les supprime et se supprime lui-même. Le jalon suivant ne peut donc pas les retrouver dans
la sandbox. Il exécute chaque cas dans un nouveau processus Python qui reçoit le programme et son entrée, mais jamais
la sortie attendue. Le système interdit à ce processus d'en lancer un autre : l'implémentation ne peut donc pas exécuter
elle-même un binaire jq. Le script affiche une ligne, par exemple jq.test 219/307.
Un tour par jalon
drive.py lance chaque jalon sous forme de tour, avec une clé d'idempotence composée du nom de la mission et
du numéro du jalon. Il attend au maximum 40 minutes et affiche chaque appel d'outil du planificateur au
moment où il a lieu. Si le jalon est encore en cours, il reçoit une instruction : interrompez vos agents de développement, puis faites un rapport. Une
interruption du tour du planificateur n'arrêterait que le planificateur, et ses agents de développement continueraient à modifier
les fichiers. drive.py attend 10 minutes de plus, évaluation comprise, puis interrompt le
jalon. Le suivant reprend à partir des fichiers écrits, et tout agent de développement encore en cours lui transmet alors
son rapport :
turn = await session.start_turn(milestone(n), idempotency_key=f"{name}:m{n}")  # a rerun gets the same turn
if isinstance(turn, agents.Busy):
    sys.exit(f"session {session.id} runs turn {turn.active_turn_id}, not a milestone: interrupt it first")
if served:
    SAVED.mkdir(exist_ok=True)
    saved_file.write_text(json.dumps({**saved, "session_id": session.id, "running": n}))
keyboard.turn = turn
record = await turn.result(after=saved.get("cursor"), timeout=MILESTONE_SECONDS, on_event=show)
if isinstance(record, agents.Running):  # time is up: an interrupt would stop the planner, not its builders
    await turn.steer(TIME_UP)
    record = await turn.result(after=record, timeout=10 * 60, on_event=show)  # the score included
if isinstance(record, agents.Running):
    await turn.interrupt()  # a builder still running reports to the next milestone
record = await turn.result()Le juge est un second agent, utilisant mistral-medium-latest, avec output_type=Verdict : un indicateur done
et une phrase de justification. Il indique que le travail est terminé lorsque le score dépasse 90 % ou que le rapport montre que l'implémentation
n'avance plus :
async def judged(report: str) -> bool:
    """Ask the judge whether the mission is done."""
    match await judge.run(report):
        case agents.Completed(output=Verdict(done=True, why=why)):
            print(f"done: {why}")
            return True
        case agents.Completed(output=Verdict(why=why)):
            print(f"{DIM}go on: {why}{RESET}")
        case other:
            print(f"{DIM}the judge gave no verdict ({type(other).__name__}): go on{RESET}")
return FalseOrienter le jalon en cours
Saisissez une ligne et appuyez sur Entrée : drive.py l'ajoute au jalon en cours avec turn.steer().
Entre deux jalons, aucun tour ne peut recevoir d'instruction, et drive.py affiche not sent. Il fait de même lorsque
turn.steer() renvoie TurnConflict parce que le jalon vient de se terminer :
async def steer(self, line: str) -> None:
    # steer() adds the line to this turn only; it never starts a turn between two milestones
    try:
        steered = self.turn is not None and isinstance(await self.turn.steer(line), agents.Turn)
    except agents.AgentsError as error:  # the session ended, or the connection did
        print(f"  {DIM}↳ not sent: {error}{RESET}")
        return
    if steered:
        print(f"  {DIM}↳ steered: {line}{RESET}")
    else:
print(f" {DIM}↳ not sent: no milestone is running{RESET}")En mode serveur : la mission continue après la fermeture du terminal
Avec agents serve, ou lorsque
vous déployez avec Studio (en auto-hébergement ou avec une gestion par Mistral), le
planificateur et ses agents de développement s'exécutent dans l'agent en mode serveur. drive.py --served lance les tours, attend et
consulte le juge. Arrêtez le pilote, puis relancez-le : les mêmes clés d'idempotence renvoient la même session et le
même jalon en cours, auquel le pilote se rattache. Il conserve l'identifiant de la session et le curseur du dernier
jalon dans .missions/.
Depuis un second terminal, watch.py suit la même session et transmet des instructions au jalon en cours :
async def main(name: str) -> None:
    session_id = json.loads((SAVED / f"{name}.json").read_text())["session_id"]
    session = agents.Agent.load_from(agent_name=agent.name).session(session_id)
    print(f"watching mission {name} · session {session_id}")
    keyboard = Keyboard()
    reading = asyncio.create_task(keyboard.read()) if sys.stdin.isatty() else None
    async for event in session.iter_events():
        show(event)
        match event:
            case agents.TurnStarted(turn_id=turn_id) if turn_id is not None:
                keyboard.turn = session.turn(turn_id)  # the milestone that runs now
            case agents.TurnEnded(state=state):
                keyboard.turn = None
                if state.text:
                    print(state.text.splitlines()[0])  # the milestone's score
    if reading is not None:
reading.cancel()Pour agents serve, l'utilisateur associé à la clé doit avoir un rôle d'espace de travail donnant accès à Workflows, comme Developer
ou Workspace Contributor ; un administrateur de l'espace de travail lui attribue ce rôle. En mode serveur, un agent avec
des sous-agents nécessite une MistralSandbox : définissez MISSION_SANDBOX=mistral dans le shell de agents serve, ou ajoutez
ENV MISSION_SANDBOX=mistral au Dockerfile généré par agents deploy. L'utilisateur associé à la clé, ou le
compte de service du déploiement, doit alors avoir le rôle cloud_user.
Le code de la mission
| Fichier | Contenu |
|---|---|
main.py | Le planificateur, le sous-agent de développement, les hooks Score et Tokens, le juge. agents serve charge agent |
drive.py | Un tour par jalon, l'affichage en temps réel, le juge, l'envoi d'instructions au clavier |
watch.py | Un second terminal pour une mission en mode serveur : ses événements en temps réel et l'envoi d'instructions |
score.py | Exécute les tests de jq réservés à l'évaluation sur l'implémentation, dans la sandbox |
skills/jq-manual/ | Le skill : le manuel de jq 1.6, ses 198 exemples sous forme de dev_tests.py, les règles d'organisation des fichiers |
held_out/jq.test | La suite de tests de jq 1.6, soit 307 cas évalués |
test_mission.py | Un test avec un modèle aux réponses prédéfinies : un jalon, évalué dans une sandbox Docker |
Le manuel et les tests de jq proviennent de jq 1.6, sous licence MIT
(skills/jq-manual/COPYING).
Exécuter la mission
Vous avez besoin de Docker. Depuis le dossier de l'exemple :
uv sync
export MISTRAL_API_KEY=...
uv run python drive.py jq-1 2 # at most 2 milestones; without a number, at most 6Pour exécuter l'implémentation dans une MistralSandbox, définissez MISSION_SANDBOX=mistral.
En mode serveur, dans trois terminaux :
MISSION_SANDBOX=mistral uv run agents serve     # terminal 1
uv run python drive.py jq-1 6 --served          # terminal 2: kill it, run it again, it attaches
uv run python watch.py jq-1 # terminal 3: the live events; type a line to steerLe test ne nécessite aucune clé : uv run pytest -o asyncio_mode=auto test_mission.py.
Sortie
Deux jalons dans une MistralSandbox (MISSION_SANDBOX=mistral), sur votre machine. Les longues séries
d'appels d'outils sont repliées, et les longues lignes du rapport se terminent par … :
jqpy/lexer.py (tokens, keywords, string interpolation scanning), jqpy/parser.py (full precedence chain: | < as < , < // < or < and < comparisons < + -…[]/{}/.., arithmetic, comparisons, if, and/or/not, //, try-catch/?, interpolation, variabl…jqpy/builtins/ (e.g. math/type predicates, object/array functions, string functions, regex/PCRE) with its manual se…jqpy/builtins/__init__.py — collections.py (flatten/sort/sort_by/group_by/min/max/unique/combinations/reverse/transpose/bsearch/contains/inside, 27→29 exampl…test/match/capture, 8 examples), objects (keys/has/in/to_entries/from_entries/with_entries, 9), paths (getpath…Les deux jalons ont pris 26 minutes. Au deuxième jalon, les quatre agents de développement ont écrit leurs modules simultanément, et le score est passé de 129 à 219. Sur les 6,9 millions de tokens, 97 % sont des tokens d'entrée : chaque appel au modèle transmet toute la conversation jusque-là, et le planificateur lit de longues sections du manuel.
L'exécution en mode serveur ci-dessous montre le premier jalon, avec les longues lignes du rapport tronquées à [...]. Le pilote a été
arrêté quatre minutes après le début du jalon, puis relancé 20 secondes plus tard. Il se rattache au jalon
en cours et rejoue ses événements depuis le début :
python3 dev_tests.py sections Identity/Index/Slice/Iterator/Comma/Pipe/Parenthesis, array/object construction, recursive des…Pendant ce temps, dans watch.py, une ligne saisie durant le premier jalon demandait d'afficher le décompte de dev_tests.py sur
la première ligne du rapport. Le rapport ci-dessus commence par ce décompte :
En mode serveur, les appels au modèle s'exécutent dans l'agent en mode serveur, et non dans le pilote. Le pilote n'affiche donc aucun décompte de tokens.
Adapter la mission
- Une autre spécification et ses tests : remplacez le manuel et la suite réservée à l'évaluation par les vôtres : une bibliothèque portée dans un autre langage, un analyseur construit à partir de sa grammaire, un client construit à partir de sa documentation de référence API. Gardez la suite hors de l'espace de travail des agents et laissez le hook évaluer chaque jalon.
- Une autre règle d'arrêt : modifiez les instructions du juge, par exemple pour arrêter lorsqu'un jalon améliore le score de moins de cinq tests.
- Des jalons plus longs ou davantage de travail en parallèle : augmentez
MILESTONE_SECONDS, ouconcurrent_child_turn_limitpour exécuter davantage d'agents de développement simultanément.