Latence
La latence semble se résumer à un seul chiffre, mais en audio elle recouvre plusieurs délais faciles à confondre : le temps que le modèle consacre au travail, la latence de bout en bout et chaque étape intermédiaire. Savoir les distinguer vous permet d'identifier ce qui est lent, de choisir le réglage qui y remédie et de mettre en balance la vitesse et la qualité.
Latence du modèle et latence de bout en bout
Distinguez deux chiffres :
- La latence du modèle est le temps que le modèle consacre au travail, mesuré sur le serveur. Elle exclut le réseau et tout ce que fait votre application.
- La latence de bout en bout est le chiffre à surveiller pour votre mode, indiqué ci-dessous. Elle commence quand votre application agit et s'arrête quand l'utilisateur voit ou entend le résultat ; elle inclut donc la latence du modèle et toutes les étapes autour d'elle.
La latence de bout en bout est toujours la plus longue des deux, et c'est dans l'écart entre les deux que se situent la plupart des problèmes de latence. Un chiffre de latence du modèle vous aide à comparer les modèles. Il ne prédit pas le temps que vos utilisateurs attendront : seule une mesure effectuée depuis votre application le fait.
Les chiffres qui comptent
Mesurez le délai que l'utilisateur perçoit, pas la durée d'un appel API. Selon le mode, il s'agit de l'un de ces délais :
- Temps jusqu'au résultat complet, pour les requêtes hors ligne : de l'envoi d'un fichier ou d'un texte à l'obtention de la transcription complète ou de l'audio complet. Surveillez-le pour le travail batch, où personne n'attend devant l'écran.
- Temps jusqu'à la première transcription, pour la transcription en temps réel : du moment où quelqu'un prononce un mot au moment où son texte atteint votre application. Surveillez-le pour les sous-titres en direct et l'entrée vocale.
- Temps jusqu'au premier audio, pour la génération de parole : de l'envoi du texte au moment où le premier son se fait entendre. Surveillez-le chaque fois que quelqu'un attend d'entendre la réponse.
- Latence par tour, pour les agents audio : du moment où l'utilisateur arrête de parler au moment où l'agent commence à répondre. Les utilisateurs y voient la réactivité de l'agent.
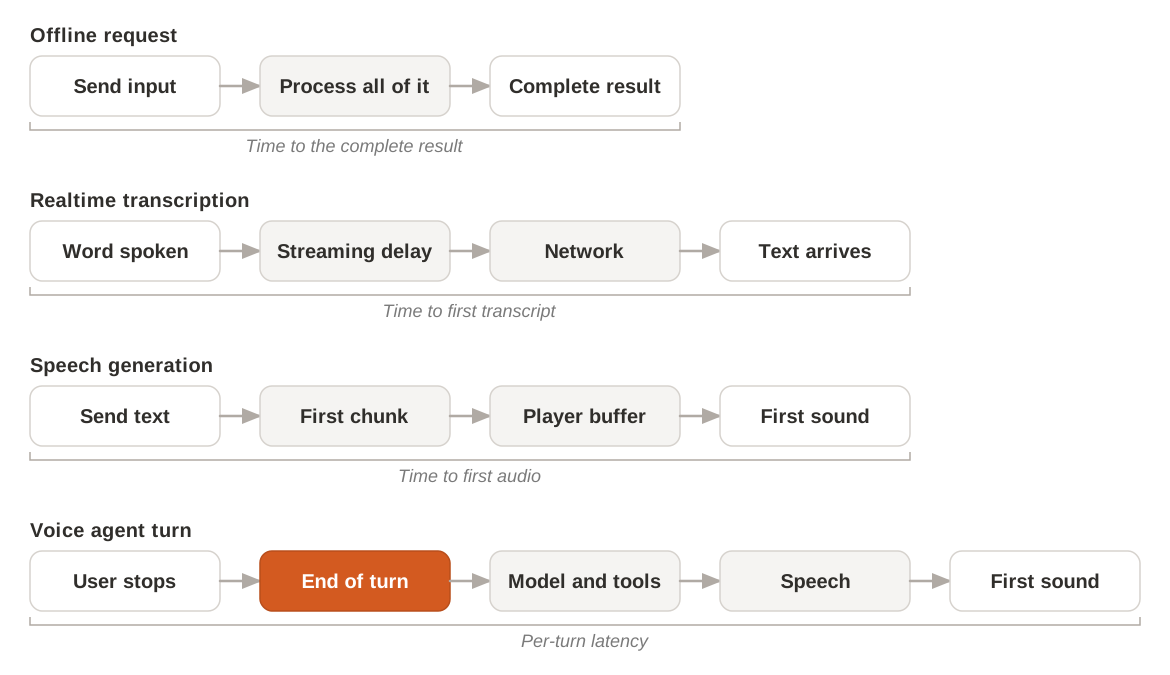
Latence par mode
| Mode | Ce que couvre la latence de bout en bout | L'origine du délai | Où ajuster |
|---|---|---|---|
| Transcription hors ligne | La transcription complète, ou ses premiers mots quand vous recevez la réponse en streaming | L'envoi du fichier, puis un temps de traitement qui augmente avec la durée de l'audio | Transcription de fichiers |
| Transcription en temps réel | Le texte de chaque mot, peu après qu'il est prononcé | Le délai de streaming que vous choisissez, puis le réseau | Transcription en temps réel |
| Génération de parole | Le premier son | La génération du premier fragment audio, puis la mise en mémoire tampon dans votre lecteur | Parole en streaming |
| Agents audio | La réponse de l'agent une fois que l'utilisateur a fini de parler | La détection de fin de tour, la transcription, le modèle, les outils et la génération de parole, l'une après l'autre | Détection de fin de tour et fillers |
L'origine du délai
Chaque requête traverse le réseau deux fois et attend le modèle. En plus de cela, chaque mode ajoute ses propres étapes. Un délai mesuré dans votre application est toujours plus long que le seul temps de traitement du modèle, car il inclut tout ce qui l'entoure.
La part du réseau dépend de la distance : entre vos utilisateurs et vos serveurs, et entre vos serveurs et l'API. Un test depuis votre ordinateur portable ne vous dit pas ce qu'attend un utilisateur sur un autre continent ; mesurez donc depuis l'endroit où votre application s'exécute et depuis celui où se trouvent vos utilisateurs.
Requêtes hors ligne
Une requête hors ligne démarre une fois l'entrée complète envoyée ; un enregistrement long prend donc plus de temps à télécharger avant que le travail commence. Le modèle traite ensuite l'entrée complète. Le temps jusqu'au résultat complet augmente avec la durée de l'audio à transcrire ou la longueur du texte à prononcer.
Quand vous recevez en streaming la réponse d'une requête hors ligne, le temps total ne diminue pas, mais les premiers mots de la transcription ou le premier fragment audio vous parviennent avant que le reste ne soit prêt. Votre application peut les afficher ou les lire pendant que le modèle travaille sur le reste. Pour la différence entre ce mode et le mode en temps réel, voir Audio hors ligne et en temps réel.
Transcription en temps réel
Dans une session en temps réel, le modèle n'écrit pas chaque mot dès qu'il l'entend. Il attend un peu pour entendre la suite, car les sons suivants l'aident à choisir le bon mot. Cette attente est le délai de streaming, et vous le définissez pour chaque session : un délai plus court fait apparaître le texte plus tôt, un délai plus long donne au modèle plus de contexte et un texte plus précis. Choisissez-le selon votre cas d'utilisation sur Transcription en temps réel.
Les sous-titres en direct et la prise de notes en profitent le plus, car les lecteurs voient les mots tout de suite et le texte final est correct.
Si votre application réagit à un événement de tour, tenez compte du texte encore en route.
Détection de fin de tour
Une pause ne signifie pas toujours que le locuteur a terminé. Pour éviter de couper la parole aux gens, la détection de fin de tour attend un silence minimum avant de clore un tour, et le clôt malgré tout à l'issue d'un délai d'expiration si le modèle n'est toujours pas certain. Cette attente vient avant tout le reste dans la réponse d'un agent, donc elle compte en entier dans la latence par tour. Un silence plus court fait répondre l'agent plus vite et l'amène à interrompre plus souvent. Tours et prise de tour explique ce compromis.
La détection envoie aussi un signal précoce, la fin anticipée, quand un tour est probablement terminé. Votre application peut commencer à préparer une réponse à ce stade, puis l'abandonner si le locuteur continue. Les réglages se trouvent sur Détection de tour.
Génération de parole
Pour la parole, ce que l'auditeur perçoit, c'est le temps jusqu'au premier audio, pas le temps de générer l'extrait complet. Quand vous générez la parole en streaming, l'API envoie l'audio par fragments au fur et à mesure de leur génération, et votre application peut démarrer la lecture dès le premier fragment. Votre lecteur ajoute sa propre attente s'il met l'audio en mémoire tampon avant de le lire : une mémoire tampon plus petite démarre la lecture plus tôt, mais augmente le risque de coupures si le flux ralentit. ; mesurez-le donc sur de nombreuses requêtes. Voir Parole en streaming.
Agents audio
Un agent audio enchaîne les étapes ci-dessus en une seule session : transcription en temps réel, modèle, puis génération de parole. Pour un tour, les délais s'additionnent dans cet ordre.
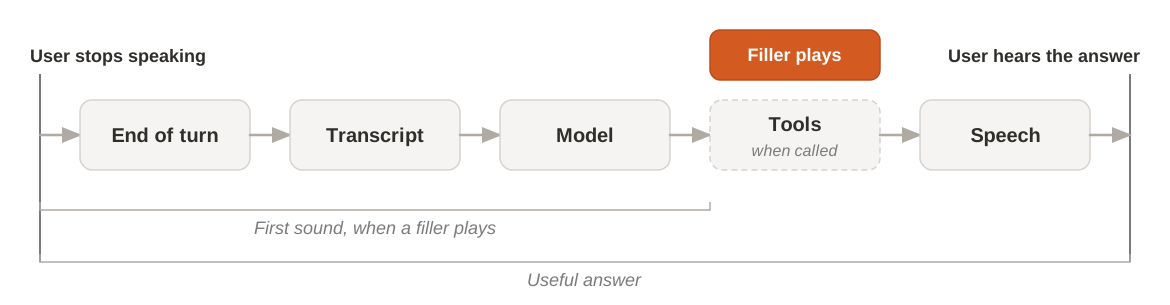
Chaque étape attend que la précédente produise quelque chose : l'étape la plus lente impose donc son rythme. Les appels d'outils sont souvent l'attente la plus longue, car ils dépendent d'un service externe au modèle, comme une recherche sur le Web ou votre propre code. Un filler couvre cette attente : l'agent joue un court extrait quand un appel d'outil commence et l'arrête quand le résultat arrive. Le filler rend l'attente plus supportable, mais ne la raccourcit pas. Voir Fillers et Agents audio.
Vitesse ou qualité
La plupart des réglages qui réduisent un délai se paient ailleurs. Changez un seul réglage à la fois, puis vérifiez ce que vous avez perdu.
| Vous raccourcissez | L'utilisateur obtient | Le coût | Détails |
|---|---|---|---|
| Le délai de streaming | Le texte plus tôt | Un texte moins précis | Transcription en temps réel |
| Le silence de fin de tour | Les réponses plus tôt | L'agent coupe la parole aux gens plus souvent | Détection de fin de tour |
| La mémoire tampon du lecteur | Le son plus tôt | Un risque accru de coupures pendant la lecture | Génération de parole |
| Le silence pendant un appel d'outil, avec un filler | Un premier son plus tôt | Rien : la réponse utile arrive au même moment | Agents audio |
Mesurer depuis votre application
Mesurez là où vos utilisateurs ressentent le délai : dans votre application, sur votre réseau, avec vos modèles et vos réglages.
Chronométrer chaque étape
Un seul chiffre de bout en bout vous dit que quelque chose est lent, pas quoi. Enregistrez un horodatage à la frontière de chaque étape, puis comparez les étapes pour trouver celle sur laquelle travailler.
| Étape | Début | Fin |
|---|---|---|
| Connexion | Votre application ouvre la session | La session est prête à recevoir l'audio ou le texte |
| Transcription | L'utilisateur prononce un mot | Son texte atteint votre application |
| Détection de fin de tour | L'utilisateur arrête de parler | Le tour se termine |
| Modèle | La transcription finale est prête | La première partie de la réponse du modèle arrive |
| Outils | Un appel d'outil commence | Son résultat est revenu |
| Génération de parole | Le texte à prononcer est envoyé | Le premier fragment audio arrive |
| Lecture | Le premier fragment audio arrive | L'utilisateur l'entend |
Comptez la connexion séparément du reste : elle a lieu une fois par session, pas une fois par tour. Pour les étapes qui commencent par la voix de l'utilisateur, prenez l'horodatage dans l'audio lui-même, pas au moment où votre code envoie une requête. En transcription en temps réel, les événements de tour indiquent la position dans le flux audio où ils se sont produits, que vous pouvez rapprocher du moment où vous avez envoyé cet audio.
Comparer des exécutions, pas des appels isolés
Un seul appel ne prouve rien : la même requête peut prendre un temps différent à chaque exécution. Répétez le même scénario de nombreuses fois et regardez deux chiffres : la médiane, pour l'expérience habituelle, et le 95e centile, pour les cas lents dont les utilisateurs se souviennent.
- Ne modifiez qu'un seul élément à la fois. Changez le modèle, le délai de streaming ou les paramètres de fin de tour, puis relancez le même scénario. Si vous modifiez deux éléments en même temps, impossible de savoir lequel a fait la différence.
- Gardez les mêmes conditions. Utilisez le même réseau, la même région et le même audio pour chaque exécution.
- Envoyez l'audio au rythme de la parole. Dans une session en temps réel, un fichier envoyé plus vite qu'en temps réel ne se comporte pas comme un microphone. Diffusez-le à son rythme réel, comme le ferait une personne qui parle en direct.
- Testez avec des conversations réelles. Les phrases courtes et claires masquent les pauses et les hésitations que la détection de fin de tour doit gérer. Commencez par des enregistrements que vous contrôlez, pour que les exécutions soient comparables ; rejouez ensuite des enregistrements d'utilisateurs réels, avec leurs accents, leurs microphones et leur bruit de fond ; terminez par des conversations complètes avec interruptions.
- Évaluez le coût de la vitesse. Après chaque modification, vérifiez la précision et les interruptions, pas seulement le temps. Voir Vitesse contre qualité.
Mesurez les fillers séparément
Un filler ou une confirmation rapide donne l'impression que l'agent est réactif, mais ce n'est pas la réponse. Pour chaque tour, notez deux moments : quand l'utilisateur entend quelque chose pour la première fois, et quand il entend la réponse utile. Si vous ne suivez que le premier, les fillers masquent un outil lent. Si vous ne suivez que le second, vous ne voyez pas ce que les fillers apportent à la conversation.