Transcription en temps réel
La transcription en temps réel convertit en texte l’audio en direct pendant que la personne parle encore. Utilisez-la dans les applications agentiques : transcrivez le flux du microphone ou du téléphone d’un utilisateur, puis transmettez la transcription à un modèle qui génère la réponse de l’assistant.
Cette page explique le déroulement d’une session du début à la fin, sa configuration, la lecture de ses événements et le compromis entre vitesse et précision.
Si l’audio est déjà enregistré, utilisez plutôt la Transcription de fichiers. Pour choisir entre les deux, consultez Audio hors ligne et en temps réel. Pour obtenir une première transcription en direct en quelques minutes, suivez le guide de démarrage : transcrire la parole en temps réel.
Comprendre le cycle de vie
Une session correspond à une connexion WebSocket qui passe par quatre étapes, toujours dans le même ordre. Votre application envoie l’audio, et l’API renvoie le texte pendant que l’audio continue d’arriver.
Lisez de haut en bas : chaque flèche représente un message, envoyé par votre application à gauche ou par l’API à droite.
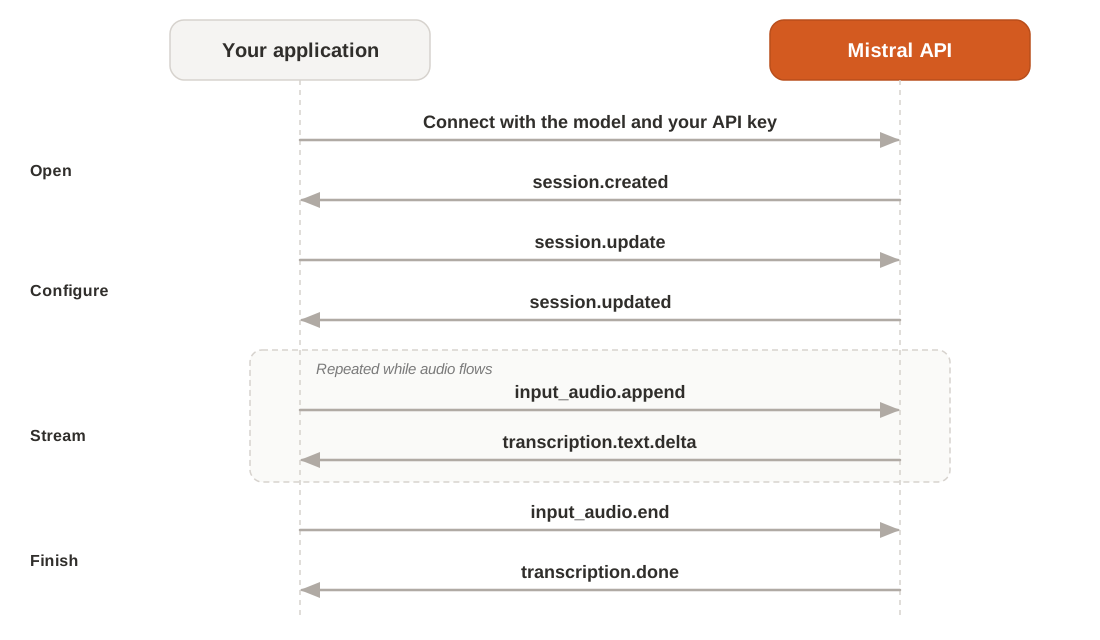
À chaque étape, votre application procède comme suit :
| Étape | Vous envoyez | Vous recevez | Ce que fait votre application |
|---|---|---|---|
| Ouverture | Une connexion avec le modèle et votre clé API | session.created, avec les paramètres par défaut | Attendez cet événement avant d’envoyer quoi que ce soit d’autre. |
| Configuration | session.update, avec vos paramètres | session.updated, avec les paramètres appliqués par la session | Vérifiez les valeurs. Elles sont figées dès le premier fragment audio. |
| Streaming | input_audio.append, un fragment audio à la fois | transcription.text.delta, avec chaque nouveau morceau de texte | Ajoutez chaque morceau de texte à la fin de la transcription affichée. |
| Fin | input_audio.end, quand l’audio s’arrête | transcription.done, avec la transcription complète | Enregistrez la transcription complète, puis fermez la connexion. |
Si l’API rejette un message, elle envoie à la place un événement error à cette étape. Consultez Problèmes courants.
Se connecter à une session
Une session est une connexion WebSocket vers l’endpoint temps réel, avec le modèle dans la chaîne de requête :
wss://api.mistral.ai/v1/audio/transcriptions/realtime?model=voxtral-mini-transcribe-realtime-3La connexion s’authentifie avec votre clé API Mistral, envoyée sous la forme Authorization: Bearer <votre clé API>. Pour créer une clé, ouvrez Clés API.
Avec le SDK Python ou TypeScript, connect() ouvre la connexion et rend la main une fois la session créée :
import asyncio
import os

from mistralai.client import Mistral

async def main():
    client = Mistral(api_key=os.environ["MISTRAL_API_KEY"])
    async with await client.audio.realtime.connect(
        model="voxtral-mini-transcribe-realtime-3",
    ) as connection:
        print(connection.session.model_dump_json(indent=2))

asyncio.run(main())Configurer la session
Envoyez vos paramètres dans un message session.update, avant le premier fragment audio. La session répond par session.updated, qui reprend chaque paramètre qu’elle applique :
{
  "type": "session.update",
  "session": {
    "audio_format": { "encoding": "pcm_s16le", "sample_rate": 24000 },
    "target_streaming_delay_ms": 480,
    "language": "en",
    "context_bias": ["Northwind", "Quillara", "Alder Creek Design", "Rotterdam"]
  }
}Le script suivant envoie ces paramètres, transmet un fichier WAV en streaming par fragments de 100 ms et affiche la transcription au fur et à mesure de son arrivée.
Le SDK Agents vocaux envoie language, context_bias et turn_detection via sa configuration stt. Pour les sessions WebSocket brutes, sans le SDK, envoyez session.update avec websockets en Python et ws en TypeScript.
import asyncio
import base64
import json
import os
import wave

import websockets

MODEL = "voxtral-mini-transcribe-realtime-3"
URL = f"wss://api.mistral.ai/v1/audio/transcriptions/realtime?model={MODEL}"
HEADERS = {"Authorization": f"Bearer {os.environ['MISTRAL_API_KEY']}"}
AUDIO_FILE = "customer_call.wav"  # 16-bit mono PCM WAV

async def send_audio(ws, path):
    with wave.open(path, "rb") as wav:
        while chunk := wav.readframes(wav.getframerate() // 10):
            await ws.send(json.dumps({"type": "input_audio.append", "audio": base64.b64encode(chunk).decode()}))
    await ws.send(json.dumps({"type": "input_audio.end"}))

async def main():
    with wave.open(AUDIO_FILE, "rb") as wav:
        sample_rate = wav.getframerate()

    async with websockets.connect(URL, additional_headers=HEADERS) as ws:
        print(json.loads(await ws.recv())["type"])  # session.created

        await ws.send(json.dumps({
            "type": "session.update",
            "session": {
                "audio_format": {"encoding": "pcm_s16le", "sample_rate": sample_rate},
                "target_streaming_delay_ms": 480,
                "language": "en",
                "context_bias": ["Northwind", "Quillara", "Alder Creek Design", "Rotterdam"],
            },
        }))
        sender = asyncio.create_task(send_audio(ws, AUDIO_FILE))

        async for message in ws:
            event = json.loads(message)
            if event["type"] == "session.updated":
                print("session.updated:", json.dumps(event["session"]))
            elif event["type"] == "transcription.text.delta":
                print(event["text"], end="", flush=True)
            elif event["type"] == "transcription.done":
                print("\ntranscription.done")
                break
            elif event["type"] == "error":
                print("error:", event["error"]["message"])
                break
        sender.cancel()

asyncio.run(main())Les paramètres sont figés une fois l’audio démarré. Un session.update envoyé après le premier input_audio.append renvoie l’erreur Session fields cannot be changed after audio has started. Pour modifier un paramètre, ouvrez une nouvelle session.
Champs de la session
session.update accepte les champs suivants. N’envoyez que ceux que vous voulez modifier : les autres gardent la valeur par défaut indiquée dans session.created.
| Champ | Type | Valeur par défaut | Utilisez-le pour |
|---|---|---|---|
audio_format | Objet : encoding, sample_rate | pcm_s16le à 16000 Hz | Décrire l’audio que vous envoyez : PCM 16 bits signé little-endian, mono, à la fréquence d’échantillonnage de votre source. Si vous ne le définissez pas, le format est déduit automatiquement des données PCM. |
target_streaming_delay_ms | Entier | 480 ms (point de départ recommandé) | Arbitrer entre vitesse et précision : toute valeur de 80 à 1200, ou 2400. Consultez Contrôler la latence. |
language | Chaîne, un code ISO 639-1 à deux lettres comme "en" | Non défini | Fixer la langue de l’audio. Sans ce champ, le modèle détecte la langue. Consultez Langues. |
context_bias | Tableau de chaînes | [] | Aider le modèle à orthographier les noms et les termes. Consultez Biais contextuels. |
diarize | Booléen | false | Étiqueter chaque morceau de texte avec son locuteur. Consultez Identifier les locuteurs. |
speaker_references | Objet : un nom pour chaque extrait audio en base64 | Non défini | Nommer des locuteurs connus, avec jusqu’à 8 extraits de 3 à 15 secondes. Nécessite diarize. Consultez Identifier les locuteurs. |
turn_detection | Objet | Non défini | Savoir quand l’utilisateur commence et finit de parler. Consultez Détection des tours de parole. |
diarize et turn_detection ne peuvent pas être utilisés dans la même session : la session renvoie l’erreur Diarization is not compatible with turn detection.
Événements : recevoir les mises à jour et terminer
Tout ce que l’API envoie arrive sous forme de message JSON avec un champ type. Lisez d’abord le type, puis les champs de l’événement correspondant :
| Événement | Champs | Envoyé quand |
|---|---|---|
session.created | session | La connexion s’ouvre, avec les paramètres par défaut. |
session.updated | session | Après chaque session.update, avec les paramètres appliqués par la session. |
transcription.text.delta | text | Un nouveau texte est prêt, pendant que l’audio arrive. |
transcription.segment | text, speaker_id, start, end | Avec diarize activé, à la place de transcription.text.delta. Consultez Identifier les locuteurs. |
turn.start, turn.eager_end, turn.resume, turn.end | time_s, et end_reason sur turn.end | Avec turn_detection activé, aux différents moments de chaque tour. Consultez Détection des tours de parole. |
transcription.done | text, segments, language, model, usage | Après input_audio.end, une fois tout l’audio transcrit. |
error | error.message, error.code | L’API rejette un message ou un paramètre. |
Afficher le texte au fur et à mesure
Chaque transcription.text.delta ajoute du texte après celui déjà envoyé. Un delta ne corrige jamais le texte précédent : votre application se contente donc d’ajouter, il n’y a rien à remplacer.
- Affichez chaque delta dès son arrivée. Il est définitif dès que vous le recevez.
- Ajoutez-le tel quel. Les deltas contiennent leurs propres espaces et leur ponctuation, comme
" for"ou".": n’ajoutez pas de séparateurs. - Enregistrez le
textdetranscription.donecomme transcription de référence.
Pour afficher d’abord un texte rapide, puis le remplacer par un texte plus précis, il faut deux sessions sur le même audio. Consultez Débit de transcription variable.
Terminer la session
Quand l’audio s’arrête, envoyez input_audio.end. L’API envoie les derniers deltas, puis transcription.done avec la transcription complète. Fermez la connexion une fois cet événement reçu.
Contrôler la latence
Le modèle utilise un délai configurable pour contrôler le temps qu’il attend entre le moment où un mot est prononcé et celui où il est transcrit :
- Un délai plus court transcrit la parole plus tôt, mais avec moins de précision.
- Un délai plus long donne plus de contexte au modèle : le texte est plus précis, mais arrive plus tard.
target_streaming_delay_ms définit ce délai pour la session. Il accepte tout entier de 80 à 1200, ou 2400. Toute autre valeur renvoie une erreur. Commencez par 480 ms, qui équilibre latence et précision. Le SDK Python peut le définir avec update_session(), en même temps que le format audio.
Pour situer ce délai dans l’attente que perçoivent vos utilisateurs, consultez Latence. Les événements de tour n’attendent pas ce délai : consultez Détection des tours de parole.
Débit de transcription variable
Les lecteurs voient les mots tout de suite, et le texte qu’ils conservent est le plus précis. Les sous-titres en direct et la prise de notes en profitent le plus.
Problèmes courants
La plupart des problèmes se traduisent par un événement error accompagné d’un message. Voici ceux propres aux sessions en direct :
| Erreur ou symptôme | Cause | Solution |
|---|---|---|
Session fields cannot be changed after audio has started. | Un session.update envoyé après le premier fragment audio | Envoyez tous les paramètres avant le premier input_audio.append. Pour en modifier un, ouvrez une nouvelle session. |
target_streaming_delay_ms must be one of the trained values | Un délai hors de la plage de 80 à 1200, autre que 2400 | Choisissez une valeur dans la plage acceptée. Consultez Contrôler la latence. |
Diarization is not compatible with turn detection. | diarize et turn_detection dans la même session | Gardez l’un des deux. Consultez Détection des tours de parole. |
Speaker references require diarization, set diarize=true. | speaker_references sans diarize | Définissez diarize sur true. |
Une erreur qui mentionne Invalid language alpha2 code | Une valeur de language qui n’est pas un code ISO 639-1 à deux lettres | Utilisez un code comme "en" ou "fr". |
| La latence mesurée sur un fichier ne correspond pas à l’usage en direct | Le fichier est envoyé plus vite que le temps réel | Pour mesurer la latence, envoyez chaque fragment au rythme de l’audio, par exemple 100 ms d’audio toutes les 100 ms. |
Pour les autres erreurs, consultez Résolution des problèmes de reconnaissance vocale.