Audio hors ligne et en temps réel
Chaque capacité audio s'exécute dans l'un de ces deux modes, et la question est de savoir si l'entrée existe avant l'appel à l'API :
- Hors ligne : vous disposez déjà de l'entrée complète, comme un enregistrement d'appel, un épisode de podcast ou un script à vocaliser. Vous l'envoyez en une seule requête. L'API traite l'intégralité de l'entrée et renvoie le résultat : une transcription complète ou un fichier audio complet.
- Temps réel : l'entrée est encore en cours de production, comme un microphone, une ligne téléphonique ou un texte qu'un modèle est en train d'écrire. Vous ouvrez une session et envoyez l'entrée par petits morceaux, par exemple 100 ms d'audio à la fois. L'API renvoie les résultats dès qu'ils sont prêts : des transcriptions partielles, des événements comme la fin du tour de parole d'un interlocuteur, ou des fragments de voix.
Choisissez d'abord le mode, avant le modèle et les options : il détermine la façon dont vous vous connectez, la vitesse à laquelle les résultats arrivent et les fonctionnalités que vous pouvez utiliser.
Choisir un mode
Répondez aux questions en commençant par le haut.
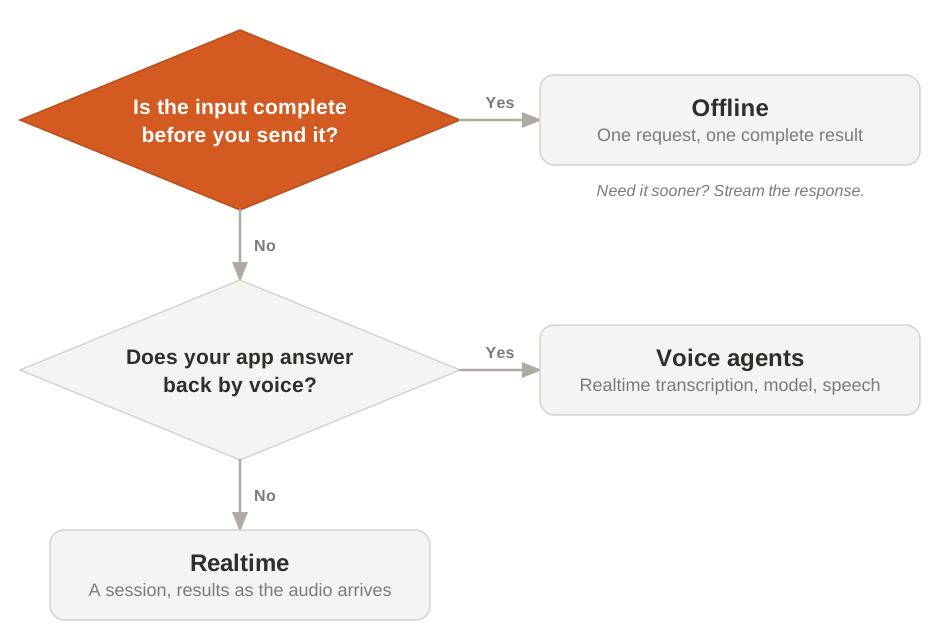
Si l'audio ou le texte existe avant l'appel à l'API, commencez par le mode hors ligne : c'est plus simple, et le modèle entend toute l'entrée avant de répondre. S'il est en cours de production pendant que l'utilisateur attend, vous avez besoin du temps réel. Si votre application répond aussi à la voix, utilisez les agents audio, qui gèrent toute la conversation pour vous. Pour choisir le modèle de chaque mode, consultez les vues d'ensemble Reconnaissance vocale et Synthèse vocale.
Ce qui change entre les modes
Le mode change la façon dont vous vous connectez, ce que vous recevez en retour et la latence que vous mesurez.
| Hors ligne | Temps réel | |
|---|---|---|
| Entrée | Complète, envoyée en une seule requête | En direct, envoyée par morceaux pendant une session |
| Connexion | Une requête HTTP | Une session WebSocket qui reste ouverte |
| Résultat | Un résultat complet, ou le même résultat envoyé par morceaux en streaming | Résultats incrémentaux et événements au fil de la session |
| Vitesse à surveiller | Temps d'obtention du résultat complet, qui augmente avec la longueur de l'entrée | Délai entre l'entrée et son résultat, que vous pouvez ajuster |
| Uniquement dans ce mode | Détection de tour de parole : savoir quand un interlocuteur a terminé | |
| Modèles | Un modèle par capacité ; consultez les vues d'ensemble Reconnaissance vocale et Synthèse vocale | Un modèle temps réel dédié par capacité |
En transcription en temps réel, vous choisissez le compromis entre vitesse et précision : un délai de streaming plus long, de 80 à 1 200 ms ou 2 400 ms, donne davantage de contexte au modèle avant qu'il ne fige le texte. Pour savoir ce qui détermine chaque délai, consultez Latence.
Pour les trois fonctionnalités
Chaque capacité prend en charge les modes différemment. Trouvez la vôtre, puis suivez le lien vers l'article qui la concerne.
| Capacité | Hors ligne | Temps réel |
|---|---|---|
| Reconnaissance vocale | Transcrire un fichier enregistré. Transcription de fichiers | Transcrire de l'audio en direct, avec détection de fin de tour de parole intégrée. Transcription en temps réel |
| Synthèse vocale | Générer la voix pour un texte complet, et éventuellement renvoyer l'audio en streaming au fur et à mesure de sa génération. Génération de voix | Diffuser la voix |
| Agents audio | Non applicable | Toujours en temps réel : une session enchaîne la transcription en temps réel, un modèle et la voix. Agents audio |
Le streaming de la réponse d'une requête hors ligne n'est pas le mode temps réel. Lorsque vous définissez stream sur une requête de transcription ou de voix, l'entrée reste complète quand vous l'envoyez : seul le résultat arrive par morceaux, et vous le voyez ou l'entendez donc plus tôt. Le temps réel commence avant que l'entrée soit complète.